StatsBeginner: 初学者の統計学習ノート

文系出身で工学部(工学研究科)の教員をしてます。

万引少年が大学教員になったケース

 高速道路か何かで149km/h出して免停になった山本太郎さんを擁護しようとして、れいわ新選組の支持者が

子供の頃に、信号無視をしたり、駄菓子を万引きしたり、自転車を盗んだりするくらいは、みんな普通にしてたよね。今回はその延長でしか無い。

と発言したのがツイッターで炎上していました。「いや、普通はしないから」というもっともなツッコミが殺到したわけです。


 そう、確かに大半の人はそんなことしないんですが、恥ずかしながら私は万引きも自転車泥棒もしたことがあり、高速道路で149km/hぐらいなら出したこともあるので、耳が痛い話です。自転車泥棒についてはツイッターに少し書きました(参考リンク)。運転は最近は穏やかなのですが、だいぶ昔に一発免停になったこともあります。私の場合は60km/h制限の新御堂筋で99km/h、つまり下道での39km/hオーバーで、1ヵ月の免停でした。前科にはなりませんが、簡易裁判所で判決をもらい、免許センターで6時間の講習を受けた記憶があります。


 万引きといえば、思い出すのは、元東大教授で評論家の西部邁先生の話です。学生時代にいろいろ教わる機会があったのですが、西部先生は中学生だった頃に万引きを繰り返していた時期があって、クズ人間で終わるのが怖くなって1年ぐらいでやめたという話をよくしていました。
 その後は、60年安保の学生運動で逮捕されて有罪になったりはしたものの、万引きのようなチンケな悪事は働かなかったらしいのですが、東大の助教授だった33歳のときに、貧乏な大学院生が腹をすかして弱音を吐いているのをみて、「男たるもの、是が非でも必要なものは法を犯してでも獲るべし」と乾物屋で食べ物を盗んで見せたという話が、『寓喩としての人生』という自伝にも書かれています。
 面白いので引用しておきましょう。

……ほとんど生物的といいたくなるような、行動力というよりも衝動力のようなものに促されて、私は万引少年になり果てた。
 自分の名誉のためにいっておきたいのだが、悪い仲間に誘われて万引をやったわけではないし、集団万引に加わったこともない。私は独りで万引をやりはじめたのだ。札幌の都心に富貴堂という本屋があった。その片隅には、スポーツ用品コーナーまであったのだから、当時としては、洒落た店だったのであろう。そこを中心に、中学二年の冬から三年の冬までの一年間ばかり、盗みをはたらいていた。その頻度は、おそらく、週に三回といったあたりではなかったろうか。少しずつ大物に手が伸びて、最後には、自分でやったことのないテニスのラケットまで頂戴するということになっていった。
(中略)
 しかし万引の一瞬の緊張とは、その寸前の恐怖とその寸後の快楽とのないまぜのことである。恐怖の体験も積み重なれば憂鬱の因となる。中学三年生のときのある冬の暮れ、凍てつく市電の戸外乗場に立ち竦みながら、私は「このままいくと自分は人間の屑になるのではないか」という思いにとらわれ、その精神的な寒さのために体をがたがた震わせていた。
 それ以後、私は万引をやったことがない。二十歳代の前半、食うに食えない生活をやっていたときも盗みははたらかなかった。自分に息子ができ、彼が私の場合よりもずっと幼くして、帰国児童としてのストレスのなかで本の万引に走ったときも、彼の首根っ子を摑まえてその本屋に突き出してやりもした。この世の現実が「統治」であることを、あるべきだということを、我が子に教えてやりたかったからである。
 いや、思い出した、三十三歳にもなってから、自分が一度だけ万引をやったことを。そのころ、東京大学助教授であった私は、娘と息子が立て続いて生まれ、貧乏といってよいような生活をしていた。しかし私のところにきていた四、五人の大学院生はもっと貧乏で、そばで聞いていると、食べ物についての心配話が多い。で、御茶の水の飲み屋に向かう途中、乾物屋の店先で何点かの食料を万引してみせ、「男たるもの、是が非でも必要なものについては、心配する前に、法を犯してでも獲るべし」と宣うたわけだ。彼らは、今、あちこちで押しも押されぬ大学教授をやっている。私のなした大学院教育のなかで彼らの記憶しているのはこの件くらいであるらしい。
(西部邁『寓喩としての人生』)


 息子さんの万引については、次の箇所に書かれています。

 そんな気分でいたある日、電話が鳴って、「こちらはスーパーダイエーの警備係ですが」と相手はいった。間髪を入れずに私は「息子が万引をやらかしましたか」と応じた。元万引少年たる私にはそれくらいの勘はすぐはたらくのである。警備室にいくと、おそらく警察官上がりの目付きの鋭い係員が「普通なら小学校の五年生だから、初犯のものは謝れば説諭してすぐ解放するが、お宅の子は絶対に謝らない。この子の先行きが心配なので親御さんを呼んだ。この子は品物が勝手に自分のポケットに飛び込んできたと言い張る。こんな子をみるのは初めてだ」という。私は、まず、野球帽をあみだに被っている息子の頬を張り、「やったんだろう、お前は、おじさんに謝れ」と怒鳴ってみせた。息子は意外と素直に、御免なさい、といった。そして脱兎のようにその場から姿を消した。
 それから数日後、深夜に妻が私を起こして、「息子の部屋に短冊のついたままの万引本がたくさんある」という。息子を叩き起こして問い質すと、彼が寝呆け眼でいうには「あのときはそばに友達が何人かいて、恥をかいた。それで、皆を集めて、もう一度やってみせるからみていろ、といったんだ。そうするしかなかったんだ」という。それを聞いて私は、内心では、なかなか見所のある息子ではないか、と感心したのだが、親たるものはそんなことは口に出せない。
 翌日、しょぼ降る雨の中を息子と二人で歩いて件の本屋に万引本を返しにいった。その雇われ店主は「この仕事を長くやっているが、みつかってもいないのに謝りにきた親子は初めてです」という。そこまではよかったのだが、続けて「坊や、いいのよ、これくらいのことは。うちの子だってあちこちで万引しているんだから」といって、私の教育的配慮を台無しにした。
(西部邁『寓喩としての人生』)


 私はこの息子さんに似ていて、小学4年生の頃に、1ヵ月間ぐらいだったと思いますが、近所の商店街にある駄菓子屋で万引きをしていました。Jという同級生がビックリマンシールを大量に揃えているのを知り、どうしたんだと聞くと万引きで手に入れたと言うので、「それはいいな」と仲間になったことがきっかけです。私ともう1人、Yという友人が加わって、3人で色々なものを盗みました。お菓子とか、アイスとか、近くの書店のマンガとか。


 きっかけこそビックリマンシールでしたが、万引きのモチベーションそのものは、スリルが9割、物欲が1割ぐらいの比率だったと思います。「ピンポンダッシュ」と同じような、ゲーム感覚のいたずらに近いですね。私の場合は西部先生と違って集団万引ですから、仲間うちでの「俺のほうがたくさん取ってきた」「俺のほうが難しいものを取ってきた」というような張り合いもありました。アイスを何本も万引きしても食べ切れないので、他の誰かにあげたり、わざわざ返しに行ったこともあった気がします。返すのは返すのでスリルがあります。


 で、その話は少しずつ、学校の友人たちに伝わっていきました。黙っておけばいいものを、どうしても「武勇伝」みたいに自分から喋ってしまうからです。あるとき、Mという友人が、「そのシールを俺にくれ。くれないと先生にチクるぞ」と脅してきたことがあって、「お前なんかにやるかボケ」と突っぱねたら、翌日さっそく担任に告げ口されて3人が呼び出されました。
 どういう行き違いがあったのか忘れましたが、その時点で担任の先生は「本屋でマンガを万引きした」という話だけを認識してしていて、すぐにその本屋へ謝りに行かされました。ちなみに、その本屋の息子は私の同級生です。店番をしていたお母さんからひとしきり説教を受けたのですが、その間、店の奥から息子が顔を出して、心配そうにこちらを覗いていたのを覚えています。で、そのお母さんから「他にはやってないのか」と問い詰められて駄菓子屋の件も白状し、お母さんが私たち3人を連れて、駄菓子屋に謝りに行ってくれました(店に払うべき代金も肩代わりしてくれた)。その後、私の親にも連絡が入り、たしか夜の8時から10時ぐらいまで長々と説教されました。


 自分で情けないと思うのは、この日の夜、親に説教されている最中に泣いてしまったことです。親に叱られたぐらいで泣くような半端なガキが、大それたことをしてはいけませんね。泣くというのは、親に怒鳴られるのが怖くて泣いているのではなく、自分のやったことを後悔して、道を踏み外したことの恐怖から泣いているんです。担任に説教を受けているときや、本屋に謝りに行ったときは、仲間と一緒だったこともありたぶん私は泣かなかったと思いますが、Yはわんわん泣いていました(Jがどうだったかは忘れた)。


 根っからの悪ガキには反省も後悔もなく、そういう奴はあまり泣きません。彼らは、道を外れることへの恐れを持っていないからです。もちろんそんな悪ガキを褒めるつもりはないのですが、犯罪をやる資格が本当にあるとしたら、そういう奴らなのだと思います。叱られて泣き出してしまうような万引き少年は、所詮、不良に憧れた善人が粋がって調子に乗っているだけです。善人というと品行方正な大多数の方からお叱りを受けそうですが、とにかく、少し誇張になりますが、持てるものを放り出して悪の道を歩もうというほどの度胸や、本当の愚かさはなく、「真人間としての日常」と「悪事のスリル」をいいとこ取りしようとしている。そういうセコいところが情けないと思うわけです。


 罪を犯したことそれ自体も反省すべきですが、それよりも、粋がって柄にもないことをしてしまったのが今でも恥ずかしくて、思い出すたびに自分が「小物」であることを実感させられます。自分は所詮、腹のすわった本物の泥棒にはなれない。そういう分際をわきまえて生きるべきだということを、万引き体験から学びました。


 自分も大学の教員をやっていて、たまにそういう昔話を学生にすることがあるのですが、もしかするとカッコ悪い意味での「武勇伝」と捉えられているかもしれないですね。そういうつもりはないのですが、面白く伝えようとするとどうしても粋がってる感じにはなるので、気をつけようと思います😓


(参考:このブログのおすすめ記事一覧はコチラ)
ステップワイズ法はp値を歪める

 さっき学生に説明したことのメモ。
 説明変数の候補がたくさんあるときに、説明力が高くなる組み合わせを機械的に選ぶステップワイズ法というのがあります。便利は便利ですが、これをやると、仮説検定の時にp値が歪みます(不当に有意になりやすくなる)。にもかかわらず、通常の回帰分析の習慣に沿った仮説検定の結果が報告されている例がよくあるので気になっています。
 ステップワイズ法で変数選択をすること自体は、目的を限定すればありだと思いますが、その場合に計算される通常のp値にはあまり意味がないので、別の指標を報告すべきと思います。これは、ステップワイズ法に限らず、データに基づいてモデル選択を行う場合に共通する「Post-selection inference」(選択後の推論)の問題ですね。


 p値はふつう、「帰無仮説が正しいとした場合に、今回より極端なデータが得られる確率」のように理解されてますが、じつはそれだけでは正確ではなく、「関心をもつ帰無仮説はデータから独立に選ばれたものである」という前提が必要になります。
 最初にどんな仮説(モデル)を検定するかを固めてしまってから、実験や調査を行ってその仮説を検定するなら、何も問題はありませんが、多くの場合、ステップワイズ法に限らず、たくさんの変数をもったデータセットを眺めてモデルの当てはまりがよくなるように変数を選んでいます。この作業を「モデル選択」「モデル探索」と呼んでいるわけですが、データに当てはまるようにモデル選択をしてしまうと、p値は小さくなる(有意になりやすくなる)方向に歪みます。
 ちなみに、たとえばサンプルサイズ5000のデータから、1000だけ取り出してステップワイズ法(もしくは手動でいろいろ試しながら)でモデル選択を行い、そのモデルを残りの4000のデータで仮説検定するなら、仮説形成と仮説検証が独立しているので、歪みは生じないです。問題の本質は、仮説形成と仮説検定を「同じデータから」やってしまうことです。


 この話は分かりにくくて、直観的には反発したくなります。たとえば目の前に、とあるデータセットがあって、分析者Aは理論的考察に基づき、自分の頭だけで思いついた仮説H0(ある説明変数の組み合わせにおける帰無仮説)の検定を行う。一方、分析者Bは、そのデータセットを使ってステップワイズ法でモデル選択を行った結果として、たまたま全く同じ仮説H0の検定を行ったとします。この場合に、分析者Aが計算しているp値だけが正しくて、分析者Bのp値は歪んでいると言われても、納得はしにくいですよね。だって、同じ計算をすれば数字は同じになるんだから。
 しかし、次のように考えれば違いが分かると思います。分析者Aと分析者Bが、同じ方法で長期的にいろいろな分析を繰り返した場合、Bのほうが常に低いp値を報告するであろうことは明白です(Aと同じp値になることはあるけど)。Bは常に、データに最もフィットするモデル(説明変数の組み合わせ)で検定をするからです。そしてこの、「繰り返すと系統的な差が生まれる」という点が大きな問題なのです。


 「仮説がどんな経緯で選ばれたにせよ、結果的に同じ仮説を採用しているなら、その仮説の下でのt分布やp値は同じなのではないか」と思ってしまいがちですが、じつは違います。いや、もう少し正確に言うと、同じ方法で計算すること自体は可能ですが、分析者Bのような仮説の選び方をする人がAと同じ方法でt値やp値を計算していると、いろいろ研究を続けていくうちに、有意水準を5%(つまりp<0.05の場合に帰無仮説を棄却して「有意な効果あり」と判断する方針)に設定していたとしても第1種過誤を犯す確率αが5%を超えてしまうので、別の方法(Selective Inferenceなど)で計算したほうがいいということになります。要するに、「使い続けた時にαと一致しない(αを目標どおりに制御できない)ようなp値を計算するのは変」というのが問題の本質です*1。


 そもそも仮説検定というのは、1回しか行わない場合でも、「仮に同じ手続きを何回も繰り返した場合」を考えて計算するもので、p=0.05というのは、「同じ手続きを繰り返したときに、今回より極端な統計量が得られるのは100回中5回ぐらい」という意味ですが、繰り返される手続きの中には「仮説は固定する」という前提が含まれていると言えます。
 t検定の原理を再確認すると、
 y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \beta_3 x_3 + \varepsilon
が真のモデルであるとき、この真のモデルを乱数発生器(母集団)と考えて、そこからサンプリング(データ生成・抽出)を行って回帰係数を推定するという手続きを何回も繰り返すと、t統計量(\betaの推定値を\betaの標準誤差で割ったもの)はt分布に従って変動することが知られています。この性質があるから、「\betaが本当はゼロだと仮定した場合に、今回得られた\betaの推定値はどれほど珍しいものか」を評価することができるわけです。
 ポイントは、サンプリングを繰り返すたびに、「同じモデル」に基づいてt値を計算するということです。同じ母集団から得られたサンプルで、同じモデルからの距離を測ることが前提であり、サンプリングを繰り返せば時には真のモデルから大きくズレたデータが生成されることもありますが、それも含めた分布を考えてるわけです。
 分析者Aは、理論的な理由から特定の仮説(ここでは「説明変数の集合」ぐらいの意味)にこだわりをもっている人なので、同じモデルに基づいてt値の計算を繰り返すという考え方と相性がいいです。データを得る前に仮説を考えているということは、仮説がデータに依存していないということで、この点が「仮説を固定して計算を繰り返す」という手続きと一貫するからです。
 一方分析者Bは、新しいデータが得られるたびに、そのデータに最もよくフィットするような「説明変数の集合」を選び直した上で仮説検定をするという方針をもっている人です。この人も、「今回ステップワイズで得られた『この説明変数の集合』を仮に真のモデルとして固定して、帰無仮説モデルから繰り返しサンプリングを行った場合のt値やp値」を計算すること自体は可能ですが、自分自身の研究スタイルと一貫性がなくなるので、長期的にはp値とαが一致しなくなり、有意性を過大評価し続けることになります。


 ステップワイズ法(等)によるモデル選択は、「データにもっともよくフィットする仮説を探索する分析」であり、それはそれで意味があります。ある具体的な仮説をもつ十分な理由がないときに、データから仮説を形成するのはひとつの合理的な方法です。ただしその場合、「それと同じデータでp値を計算したら意味がない」ということになります。単に「このモデルがAIC最小のモデルです!」と報告するだけに留めるなら問題はないですし、データを2つに分割して、片方でモデル選択を行い、他方でモデルの検定を行ってp値を報告するなら意味があります。
 あるいは、きちんと仮定を置けるなら、参考記事で書かれているようなSelective Inferenceをやるという手もあります。これは、データに基づいてある仮説(説明変数の組合せ)が選択された場合に、「そのモデル構造と与えられたxのデータの下で、『その説明変数の組合せ』が選択されるようなyの空間」を考えて、誤差の分布を条件付き分布に補正してp値等を求めるものですね*2。


〈参考1〉Post-selection inferenceについてのまとめ論文で、主な対処法を、①サンプル分割(上述の分けるパターン)、②simultaneous inference(全ての仮説を考えてどれか1個でも帰無仮説を誤って棄却しないよう超保守的に検定する)、③Conditional Selective Inference(仮説選択の手続きを考慮して補正する)の3つに整理しています。
Post-Selection Inference | Annual Reviews

〈参考2〉Selective Inferenceのやり方が解説されています。
仮説検定における変数選択の影響を考えるSelective Inference入門 with R. #データ分析 - Qiita

〈参考3〉よく参照される論文で、ステップワイズ法という言葉は出てこないけど、下記の論文で言われているscreening regression equationsは、要するにデータに基づいてスクリーニングされた回帰式という意味です。
Freedman, D. A. (1983). A Note on Screening Regression Equations. The American Statistician, 37(2), 152-155.


(参考:このブログのおすすめ記事一覧はコチラ)

*1:帰無仮説の下では0〜1の間で一様分布する(だから0.05以下になる確率がちょうど5%)はずのp値が、小さい方に偏ってしまうというふうにも言えます。

*2:ある説明変数の組合せが選択されるという条件を、いくつかの線形不等式で表して、その不等式でyの空間を多角形(多面体)状に切り抜いて、その範囲内でしかyが動かないとした場合の、誤差や検定統計量の分布を考える。yの分布が変わるとtやpの分布も変わる。

対数変換して求めた予測値を指数で再変換するときの下振れの補正(スミアリング)

 昨日学生に説明したことのメモ。
 世の中には、何かと何かの「掛け算」で決まっていそうなものが色々あります。たとえば、私はオフロードバイクで山を走るのが好きなのですが、オフロードの走破能力は、マシンの性能と自分の技量の「掛け算」で高まるのだという実感があります。足し算ではなく相乗効果があるということですね。

 走破能力 = マシンの性能 × 自分の技量

 他にも、経済学に出てくるコブ=ダグラス型生産関数では、技術(生産性)×資本×労働力で供給力が決まるというふうに定式化されています。


Y = A \cdot K^{\alpha} L^{\beta}

Y:生産力
A:全要素生産性(TFP) ※これはパラメータとして推定される
K:資本
L:労働力


 また、交通や物流の分野では、地域間のフローをモデル化するのに重力モデルというのが使われたりします。天体の間に働く重力は、それぞれの天体が重ければ重いほど強く、また距離が離れるにつれて弱くなりますが、そのアナロジーで、2つの都市の人口が大きければ大きいほどその間の交易が盛んになり、距離が遠くなると交易が減るということです。ニュートン力学だと分母は距離の2乗ですが、何乗するかはパラメータとして推定します。


T_{ij} = G \cdot \frac{M_i^{\alpha} M_j^{\beta}}{d_{ij}^{\gamma}}

T_{ij}:都市iから都市jへの交易フロー(人流や物流など)
G:重力定数 ※これはパラメータとして推定される
M_i, M_j:都市iと都市jの規模(人口や経済力など)
d_{ij}:2都市間の距離


 こういう乗法的な関係をモデリングするとき、伝統的には、両辺の対数をとって線形結合の形に変換します。データの各変数を対数化しておけば、そのまま線形回帰でパラメータを推定できるからです。

\log T_{ij} = \log G + \alpha \log M_i + \beta \log M_j - \gamma \log d_{ij}

 ところで、こういう形でOLSにより推定されたモデルを使ってYやTの予測値を出すのであれば、まず\log Yや\log Tの値を出してからそれを\exp(\log T)というふうに指数変換して元の真数スケールに戻すわけですが、これだけだと、予測値が系統的に下振れしてしまう再変換バイアスが生じますので、何らかの補正が必要です。
 なんでかというと、まずイエンセンの不等式というのがあって、下に凸な関数fに関して

E[f(X)] \geq f(E[X])

もしくは分かりやすくいうと

\mathrm{mean}(f(X)) \geq f(\mathrm{mean}(X))

ということですが、これは要するに、ある変数群の平均をとってから関数を適用すると、先に関数を適用してから平均をとるのに比べて、小さくなるということです(等しい場合もある)。
 さっきの対数線形回帰においては、誤差項の扱いでこれが問題になります。要は、


\log T_{ij} = \log G + \alpha \log M_i + \beta \log M_j - \gamma \log d_{ij} + \varepsilon_{ij}


 という形でOLS回帰をすると、「誤差の平均をゼロ」にするような線を引くことになるので(線ではないがw)、推定されたパラメータを使って「対数スケールでの予測値」を求める段階では、誤差項はどうせ平均的にはゼロになるものとして無視できます。ところが、対数化した世界で誤差項の平均\mathrm{mean}(\varepsilon)がゼロであっても、それを\exp()した真数のスケールでは\mathrm{mean}(\exp(\varepsilon))が1(対数スケールでの0に対応)より大きくなってしまうので、予測値をつくるときに誤差項の影響を復活させる必要があります。
 具体的には、対数線形モデルを\exp()すると乗法モデルの形になるので、\mathrm{mean}(\exp(\varepsilon))を補正係数として予測値にかければよい。これにより、予測値が上方修正されます。これがスミアリング法です。
 ちなみに、GLMで「logリンク+ガンマ分布」を使ったりするのであれば、平均構造を直接モデル化するので、こういう下振れは生じません。


 以下、試しに、3つの説明変数からなる乗法モデルで乱数データセットを生成し、

  1. 単なる線形回帰でパラメータ推定して予測値を求める
  2. 対数変換してから線形回帰で推定して予測値を指数変換で戻す
  3. 対数変換してから線形回帰で推定して予測値を指数変換で戻してスミアリング補正
  4. GLMのlogリンク+ガンマ分布(対数正規分布が直接指定できないので)で推定して予測値を求める


の4パターンでどれぐらいズレるかを試してみました。
 結果はこうなりました。RMSEは誤差を絶対値で評価するもの、sMAPEは誤差を割合で評価するもので、いずれも小さければ小さいほどフィットが良いです。Biasは、正負の方向つきで、モデル予測値が実測値(乱数)から平均的にどれぐらいズレてるかを表すものです。

> print(summary_table)
                   Model Mean_RMSE Mean_sMAPE Mean_Bias
1              naive OLS   43.2946     0.7949   -0.0530
2 Log-linear + naive exp   29.0960     0.3118   -2.8425
3  Log-linear + smearing   28.6847     0.3177    0.0006
4         GLM Gamma(log)   28.6884     0.3177   -0.0048


 まず、単なるOLS(1)だとRMSEもsMAPEも一番大きくなっていて、要するに当てはまりが一番悪い。指数的なモデルを線形でモデリングしてるのだから、当然です。ただ、バイアスは小さくて、これは真数のスケールで誤差の平均がゼロになるような推定をしてるからでしょう。
 対数線形モデル+スミアリング補正(3)と、GLM(4)については、RMSEもsMAPEも小さくて、バイアスも小さいです。微妙にGLMのほうがバイアスが大きいのは、対数正規分布ではなくガンマ分布を使ってるからでしょうかね。
 で、ポイントは、対数線形回帰の予測値を単純に指数変換で戻しただけ(2)だと、バイアスが負で大きくなっていて、要するにめちゃめちゃ下振れしています。
 GLMが手っ取り早くていいと思いますが、線形回帰モデルのほうが分かりやすいからか、私がいる分野(交通関係)ではよく使われている印象で、予測値をつかってシミュレーションをする(かつその水準が問題になる)のでなければ、補正の話は必要ないので出てこないです。そして、出てこないので、下振れのリスクを意識してなくて計算をミスったりします(笑)


(参考:このブログのおすすめ記事一覧はコチラ)


 乱数実験のRのコードを置いておきます。ChatGPTに書いてもらったものを手動で調整しました。

# ============================================================
# 乱数実験:
# 真のデータ生成過程を「弾力性モデル」にする
#
# 乗法(弾力性)モデル:
# y = exp(beta0) * x1^beta1 * x2^beta2 * x3^beta3 * u
# ただし u = exp(eps), eps ~ N(0, sigma_true^2)(対数正規誤差)
#
# その上で
# 1) 線形回帰(y ~ x1 + x2 + x3)
# 2) 対数線形 + 単なるexp(補正なし)
# 3) 対数線形 + exp + スミアリング補正
# 4) GLM (logリンク、Gamma分布)
# を比較する
#
# 出力する指標:
# RMSE, sMAPE, Bias(ズレ)
# ============================================================

set.seed(123)

# -------------------------------
# シミュレーション設定
# -------------------------------

n_sim <- 1000     # シミュレーション回数
n_train <- 1000   # 学習データ数
n_test  <- 10000  # テストデータ数

# 真のパラメータ
beta0 <- 1.0
beta1 <- 2.0
beta2 <- 0.8
beta3 <- -0.6

# 対数スケールでの誤差の標準偏差
# 大きいほど元のスケールでのばらつきが大きくなる
sigma_true <- 0.4

# 結果保存用
results <- data.frame(
  sim = 1:n_sim,
  
  RMSE_linear     = NA,
  RMSE_log_naive  = NA,
  RMSE_log_smear  = NA,
  RMSE_glm        = NA,
  
  sMAPE_linear    = NA,
  sMAPE_log_naive = NA,
  sMAPE_log_smear = NA,
  sMAPE_glm       = NA,
  
  Bias_linear     = NA,
  Bias_log_naive  = NA,
  Bias_log_smear  = NA,
  Bias_glm        = NA
)

# ============================================================
# シミュレーション開始
# ============================================================

for (s in 1:n_sim) {
  
  # -------------------------------
  # 1. 学習データを作る
  # -------------------------------
  # 説明変数は正の値が必要なのでexpでつくる
  x1_train <- exp(rnorm(n_train, mean = 1.0, sd = 0.5))
  x2_train <- exp(rnorm(n_train, mean = 0.5, sd = 0.4))
  x3_train <- exp(rnorm(n_train, mean = 0.8, sd = 0.6))
  
  # 真のモデル(弾力性モデル)
  eps_train <- rnorm(n_train, 0, sigma_true)
  
  y_train <- exp(beta0) *
    (x1_train ^ beta1) *
    (x2_train ^ beta2) *
    (x3_train ^ beta3) *
    exp(eps_train)
  
  train_dat <- data.frame(
    y  = y_train,
    x1 = x1_train,
    x2 = x2_train,
    x3 = x3_train
  )
  
  # -------------------------------
  # 2. テストデータを作る
  # -------------------------------
  x1_test <- exp(rnorm(n_test, mean = 1.0, sd = 0.5))
  x2_test <- exp(rnorm(n_test, mean = 0.5, sd = 0.4))
  x3_test <- exp(rnorm(n_test, mean = 0.8, sd = 0.6))
  
  eps_test <- rnorm(n_test, 0, sigma_true)
  
  y_test <- exp(beta0) *
    (x1_test ^ beta1) *
    (x2_test ^ beta2) *
    (x3_test ^ beta3) *
    exp(eps_test)
  
  test_dat <- data.frame(
    y  = y_test,
    x1 = x1_test,
    x2 = x2_test,
    x3 = x3_test
  )
  
  # ============================================================
  # 3. モデル1:何も考えない線形回帰
  #    y ~ x1 + x2 + x3
  # ============================================================
  
  fit_linear <- lm(y ~ x1 + x2 + x3, data = train_dat)
  
  pred_y_linear <- predict(fit_linear, newdata = test_dat)
  
  # ============================================================
  # 4. モデル2:対数線形モデル + naive exp
  #    log(y) ~ log(x1) + log(x2) + log(x3)
  # ============================================================
  
  fit_log <- lm(log(y) ~ log(x1) + log(x2) + log(x3), data = train_dat)
  
  pred_log_test <- predict(fit_log, newdata = test_dat)
  
  # 補正なしでそのまま exp で戻す
  pred_y_naive <- exp(pred_log_test)
  
  # ============================================================
  # 5. モデル3:対数線形モデル + smearing 補正
  # ============================================================
  
  resid_log <- residuals(fit_log)
  
  # スミアリング係数
  smear_factor <- mean(exp(resid_log))
  
  pred_y_smear <- exp(pred_log_test) * smear_factor
  
  # ============================================================
  # 6. モデル4:GLM (Gamma, log link)
  #    y ~ log(x1) + log(x2) + log(x3)
  # ============================================================
  
  fit_glm <- glm(
    y ~ log(x1) + log(x2) + log(x3),
    family = Gamma(link = "log"),
    data = train_dat
  )
  
  pred_y_glm <- predict(fit_glm, newdata = test_dat, type = "response")
  
  # ============================================================
  # 7. 予測精度を計算
  # ============================================================
  
  # ---- RMSE ----
  rmse_linear <- sqrt(mean((y_test - pred_y_linear)^2))
  rmse_naive  <- sqrt(mean((y_test - pred_y_naive)^2))
  rmse_smear  <- sqrt(mean((y_test - pred_y_smear)^2))
  rmse_glm    <- sqrt(mean((y_test - pred_y_glm)^2))
  
  # ---- sMAPE ----
  # 0〜2の範囲
  smape_linear <- mean(abs(y_test - pred_y_linear) / ((abs(y_test) + abs(pred_y_linear)) / 2))
  smape_naive  <- mean(abs(y_test - pred_y_naive)  / ((abs(y_test) + abs(pred_y_naive))  / 2))
  smape_smear  <- mean(abs(y_test - pred_y_smear)  / ((abs(y_test) + abs(pred_y_smear))  / 2))
  smape_glm    <- mean(abs(y_test - pred_y_glm)    / ((abs(y_test) + abs(pred_y_glm))    / 2))
  
  # ---- Bias ----
  # 平均予測誤差:予測値 - 実測値
  bias_linear <- mean(pred_y_linear - y_test)
  bias_naive  <- mean(pred_y_naive  - y_test)
  bias_smear  <- mean(pred_y_smear  - y_test)
  bias_glm    <- mean(pred_y_glm    - y_test)
  
  # ============================================================
  # 8. 保存
  # ============================================================
  
  results$RMSE_linear[s]     <- rmse_linear
  results$RMSE_log_naive[s]  <- rmse_naive
  results$RMSE_log_smear[s]  <- rmse_smear
  results$RMSE_glm[s]        <- rmse_glm
  
  results$sMAPE_linear[s]    <- smape_linear
  results$sMAPE_log_naive[s] <- smape_naive
  results$sMAPE_log_smear[s] <- smape_smear
  results$sMAPE_glm[s]       <- smape_glm
  
  results$Bias_linear[s]     <- bias_linear
  results$Bias_log_naive[s]  <- bias_naive
  results$Bias_log_smear[s]  <- bias_smear
  results$Bias_glm[s]        <- bias_glm
}

# ============================================================
# 9. 平均結果を表にまとめる
# ============================================================

summary_table <- data.frame(
  Model = c(
    "naive OLS",
    "Log-linear + naive exp",
    "Log-linear + smearing",
    "GLM Gamma(log)"
  ),
  Mean_RMSE = c(
    mean(results$RMSE_linear),
    mean(results$RMSE_log_naive),
    mean(results$RMSE_log_smear),
    mean(results$RMSE_glm)
  ),
  Mean_sMAPE = c(
    mean(results$sMAPE_linear),
    mean(results$sMAPE_log_naive),
    mean(results$sMAPE_log_smear),
    mean(results$sMAPE_glm)
  ),
  Mean_Bias = c(
    mean(results$Bias_linear),
    mean(results$Bias_log_naive),
    mean(results$Bias_log_smear),
    mean(results$Bias_glm)
  )
)

summary_table[, -1] <- round(summary_table[, -1], 4)

print(summary_table)

紙の教科書とデジタル教科書の教育効果を比較した研究のまとめ

 参政党の神谷代表が、「デジタル教科書より紙の教科書のほうがいい」という主張をしているらしく、個人的には賛成ですが、いろんな研究があるので場合をわけて考えたほうがいいと思います。


 紙の教科書とデジタル教科書の教育効果を比較した研究は山ほどあって、それらを横断的に整理・分析した「システマティックレビュー」や「メタアナリシス」の論文もたくさん出ています。2024年の秋ぐらいに、とある仕事で必要があってそういう論文を10本ぐらい?読んだときのメモが出てきたので、次節以降に貼り付けておきます。
 学術論文を書くために整理したものではなく、とある団体の会報誌の原稿を書くときに作った簡単なメモなので、偏りもあるし、ほぼアブストと結果の表しか読んでないものも含むので(笑)、あくまで参考程度です。
 大まかには、

  • デジタル教材の優位性を示した研究もいろいろあるのだが、読解そのものというより、付加機能(動画やフィードバックや個人ごとのカスタマイズ)がいい感じに働いているという話なので、直接比較が難しいという点を念頭に置く必要がある。
  • 単なる読解についていうと、説明文を読む場合は紙のほうが少し有利で、物語文だと差がない。
  • デジタル教科書は、「分かった気になる」過信を生みやすいという傾向がある。

という感じですかね。

レビューやメタアナリシス


Delgado, P., Vargas, C., Ackerman, R., & Salmerón, L. (2018). Don't throw away your printed books: A meta-analysis on the effects of reading media on reading comprehension. Educational research review, 25, 23-38.

 2000年~2017年の54件の研究に対するメタ分析。紙媒体とデジタルデバイスで、同じ内容の文章の読解を比較した研究に限定している(電子書籍にいろいろ付加機能がついてると純粋な比較にならないので)。総じて、紙の教科書のほうが教育効果が高いという結果が出ているが、面白い発見としては、
(1) 自分のペースで読書できる場合より、時間制限がある場合に、紙の優位性が顕著になる。
(2) 物語文のみなら、紙でもデジタルでも違いがないが、説明文・情報文や、説明と物語の混合文だと、紙が有利になる。
(3) なぜか、新しい研究ほど、紙の優位性が強くなっている傾向がある。

Clinton, V. (2019). Reading from paper compared to screens: A systematic review and meta‐analysis. Journal of research in reading, 42(2), 288-325.

 システマティックレビューとメタ分析を行い、29本の論文から33件の実験を抽出した。無作為割り当てによる実験を行ってて、基本的な読解力を有する参加者が対象であり、2008年から2018年の間に発表された研究が対象。全体としては、紙のほうがわずかに教育効果が高い。説明文では紙のほうが有利で、物語文では差がない。理解度についての自己評価は紙のほうが正確で、デジタルだと自分の理解を過信する(分かった気になる)傾向がある。年齢による媒介効果はないので、子供でも大人でも同様(紙で勉強してきた人たちはそれに慣れてるだけでは?という指摘がよくあるので、大人と子供の比較は重要)。

Zhang, R., Zou, D., Xie, H., Au, O. T. S., & Wang, F. L. (2020). A Systematic Review of Research on E-Book-Based Language Learning. Knowledge Management & E-Learning, 12(1), 106-128.

 言語教育に関する過去10年間の52の実証研究の結果を整理。総じて、電子書籍はプラスの効果を持つことが示唆されていると言えるが、研究の多くは未就学児と大学生を対象にしたものに偏っている。また、電子書籍が効果的なのは、付加価値的な機能が付いているからである。「マルチメディア」「フィードバック提供」「ゲーミフィケーション」「個別化」が、学習の効率性を高めるためによく導入されている。なので、単純に読解力だけを比較しているわけでもない。

Egert, F., Cordes, A. K., & Hartig, F. (2022). Can e-books foster child language? Meta-analysis on the effectiveness of e-book interventions in early childhood education and care. Educational Research Review, 37, 100472.

 2000年から2018年までに行われた17の実証研究のデータについてメタ分析を行っている。保育園レベルの幼児の読解力に関する研究で、印刷した本の読み聞かせよりも、電子書籍のほうが有意に効果が高いことが分かった。ただしこれは、純粋な紙と電子の比較というより、子供の注意を引くための様々な工夫が入っているからである。アニメーションによって物語の理解を助けたり、音声や音楽で効果を出したり、文字を自動でハイライトすることによってどこを読むかを示したり、辞書の機能がついていたり、物語の内容に関連したミニゲームがついていたりする。

Suriani, N. M., Agustini, K., Sudhata, I. G. W., & Dantes, G. R. (2023). The Effectiveness of E-book in Learning Process: A Systematic Literature Review. International Journal of Social Sciences, 6(2), 43-50.

 2020年から2022年までの10件の研究を整理したもので、多くの研究でe-bookは紙の本と同等以上の学習効果を示した。PDF教材は10件中7件、インタラクティブ教材は10件中5件で使われていた。一部、e-audiobookも使われている。インタラクティブe-bookが最も効果的とされ、その理由は、テキスト・画像・動画を組み合わせて複雑な内容を視覚的に説明できるため。ただし、不要なインタラクティブ機能が読解の妨げになることもある。ゲーム要素を加えた「ゲーミファイドe-book」の可能性も示唆されているが、研究数が少なく今後の検討が必要。

International Publishers Association and Norwegian Publishers Association (2020). Paper and Digital Current research into the effectiveness of learning materials.

 国際出版連合のプロジェクトチームが4年間にわたる研究の成果をまとめた報告書で、長い文章や複雑な文章を読む上では、紙媒体のほうが効率的で、より深い理解をもたらすものだと主張されている。一方、グループワーク、迅速な情報処理、ドリルのような演習、問題解決型の教育には、デジタル教材を用いることが効果的であるとされている。
 「デジタルテキストの表示が個人の好みやニーズに適切に合わせられている場合、理解力は向上する可能性があるものの、そうでない場合、読者は自身の理解力について過信し、 デジタルで読む際には、より多くのスキミングと読解への集中力の欠如につながる」ということらしい。

Rahim, F. R., Suherman, D. S., & Muttaqiin, A. (2020). Exploring the effectiveness of e-book for students on learning material: A literature review. In Journal of Physics: Conference Series (Vol. 1481, No. 1, p. 012105). IOP Publishing.

 物理の教育(主に高校)における電子ブックの教育効果を検証した12本の論文をレビューしたもので、すべての研究で電子ブックは効果的とされている。あまり具体的に紹介されていないのでよくわからないが、物理が苦手な学生は多く、実験などの様子を動画やアニメーションで伝えられるというメリットが大きいという主張。

Singer, L. M., & Alexander, P. A. (2017). Reading on paper and digitally: What the past decades of empirical research reveal. Review of educational research, 87(6), 1007-1041.

⇒ システマティックレビューを通じて、紙とデジタルの比較を行った数十件の研究が、読書を明確に定義しておらず、使用されたテキストの「内容と量」を適切に提示していない、個人差要因をほとんど考慮していないといった問題があると批判している。


実験研究(たまたま読んだものだけ)


Merkle, A. C., Ferrell, L. K., Ferrell, O. C., & Hair Jr, J. F. (2022). Evaluating E-book effectiveness and the impact on student engagement. Journal of Marketing Education, 44(1), 54-71.

 経営学部の授業で、紙の教科書と電子教科書の教育効果を比較した。秋学期に259人、春学期に395人の学生を対象とした準実験的手法で調査を行った。結果は、電子書籍は紙の教科書に比べて、学生のエンゲージメントに関していくつかの側面ではプラスの影響をもつ一方で、他の側面では中立的あるいはマイナスの傾向の影響をも持つことが分かった。また、電子書籍の有効性が科目によって大きく異なることも分かった。
 プラスの影響としては、演習に関してオンラインで即時のフィードバックが得られることなどによって、学生のエンゲージメントが高まった。一方、デバイス間での互換性の問題や、紙に比べて使いはじめが複雑であること、目が疲れるといったマイナス面もあることが指摘されている。
 科目によって効果が異なり、テクノロジーに関する授業などでは高い効果があったが、マーケティング原論のように伝統的な基礎科目では効果が低かった(★面白い)。

Richter, A., & Courage, M. L. (2017). Comparing electronic and paper storybooks for preschoolers- Attention, engagement, and recall. Journal of Applied Developmental Psychology, 48, 92-102.

 これは面白い(★)。79人の未就学児に対して、紙とタブレットで物語の読み聞かせの比較を行ったのだが、電子書籍のほうが、子供は強い関心をしめした。ところがその関心というのは、機器そのものへの関心であった。ストーリーの内容への関心は、紙の本のほうが強く出た。なお、ストーリーの理解や記憶の定着に関しては、電子でも紙でも差はない。
 また重要なこととして、電子書籍については、紙よりも読む時間が2倍多くかかっている。なぜかというと、本の内容よりもデバイスそのものの操作に興味が湧いたからという面もあるし、紙だと見開きなのに対し電子では1ページ1枚だったのでページ送り操作が増えるというのもあるし、タッチすると何かアクションが起きる部分で遊んだり、音声やアニメーションが伴っているからであった。

Singer, L. M., & Alexander, P. A. (2017). Reading across mediums: Effects of reading digital and print texts on comprehension and calibration. The journal of experimental education, 85(1), 155-172.

 90人の大学生に、子供の病気に関する文章を、紙とデジタルで読ませて比較した。学生は普段はデジタルテキストをよく読んでいるという人が多数で、読んだ後の自己認識でも、「デジタルで読んだほうがよく理解できた」と7割の学生が答えていた。しかし理解度チェックを行うと、テーマレベルでの理解については紙でもデジタルでも差がなかったが、個々の具体的な情報の理解や記憶は、紙のほうが優れていた。デジタルだと自己理解を過信してしまうということと、大雑把な粒度での理解についてはデジタルでも大丈夫という点が重要。

Lenhard, W., Schroeders, U., & Lenhard, A. (2017). Equivalence of screen versus print reading comprehension depends on task complexity and proficiency. Discourse Processes, 54(5-6), 427-445.

 教科書ではなくテストの実験だが、テストで違いが出る理由の説明が面白かったので載せておく。1年生から6年生までの2807人の児童を対象に、ドイツ語(国語)のテストを紙かコンピュータで受けさせる実験を行ったところ、特に単語レベルの設問に関してコンピュータを使った児童の方が解答は早かったが、正解率低いというトレードオフが生じた。文レベルの設問になったり、あるいは学年が上がるにつれて、違いはなくなっていく。マウス操作は鉛筆よりも誤クリックを止めにくいこと、コンピュータでは1問ずつ表示されていて見直しができない、テレビゲームのノリで「速く浅く処理する」モードになってしまうなどの原因が考えられている。

「便所の落書き」は楽しかった

 昔、掲示板サイトの2ちゃんねるがよく「便所の落書き」と批判されていて、いまのSNSも同じように言われることがありますが、最近の都会のトイレは総じて綺麗で、落書きというものを見ることがほぼなくなりました。なので、そもそも便所の落書きとはどんなものか、どういう気持ちで書くものなのかを若者に伝える義務があると感じています。


 大学時代、私が主に授業を受けていた建物は1階にトイレがあって、男子トイレはたぶん個室が3つぐらい付いていたと思います。個室の内側の壁にはだいたい何かしら落書きがされているのですが、よく見かけるのは、「○○ちゃんかわいい!」と好きな女の子への愛を叫ぶものや、単なる下ネタや、嫌いな人の電話番号を書いていたずら電話を誘うものなどでした。電話番号は、大学に限らずトイレの落書ではよく見かけるもので、本当かどうかは分からないけど、クスリの取引やゲイの出会いを匂わせるものもありましたね。


 で、そのトイレの一番左端の個室は、洋式便器に腰を掛けると目の前に見えるあたりに、誰かが「一学2ちゃんねる」と書いた領域がありました。「一学(いちがく)」というのはその建物の名前です。
 「一学2ちゃんねる」は、その個室で用を足す人たちが交換日記のように使っていて、鉛筆やボールペンで

今日もいいウンコが出た
おめでとう、俺もだ
次テストだけど勉強してないわ
がんばれ

というような他愛もない会話が書き込まれていました。自分が何を書いたかは思い出せませんが、だいたい似たようなレベルの、どうでもいいことしか書いていないと思います。


 この「一学2ちゃんねる」には独特な楽しさがありました。読んでいるだけだとあまり何も思わないのですが、自分で書き込むようになると不思議な緊張感を覚えるもので、「次ウンコするときに返信が付いてたらいいな」と少しワクワクするような面もありました。
 匿名のコミュニケーションは「無責任だ」と言われることが多く、それはまぁ確かにそうだと思いますが、お互いの素性が分からないからこそ得られる妙な連帯感というものもあります。少なくとも「一学2ちゃんねる」は、他の個室の壁に比べれば和気あいあいとしていて、荒れることもありませんでした。


 会話の相手が先輩なのか後輩なのかも分からないが、とにかく俺たちはこの同じ便器に座って用を足し、同じ壁を見つめている。そこに「強い絆」というほどのものはないにしても、赤の他人というわけではないし、何より俺たちは互いに話したがっている……。素性を隠しながら同じ目的のために協力する、秘密結社のような感じにも近いかも知れません。

 
 コミュニケーションのチャネルは、太ければ太いほど良いというものでもないのだと思います。家族や同級生のように、頻繁に顔を合わせることで育まれる絆はもちろん大事なのですが、逆に「この人とは、今ここでしか話せないかもしれない」「返事はもらえないかも知れない」という儚さが、「今ここ」の会話に良い意味での緊張を与える場合もあるんですよね。壁に隔てられて、相手を深く知ることができないからこそ、「話したい」という気持ちが強くなるとも言えます。子供時代の友だちや海外旅行先で話しかけてくれた現地人など、もう連絡が取れない人との会話が、かけがえのない思い出になっているということもよくあります。


 スマホを初めて買った頃、「Qボトル」というアプリを使ったことがあります。ビンに手紙を入れて海に投げると、そのうちどこかの海岸に流れ着いて誰かに読まれるみたいな話がありますが、そのイメージで、誰に届くか分からないメッセージを適当に送信するアプリです。受け取った人がその送り主に返信をすることもできて、少しだけ1対1の会話が成り立つようになっていました。最近は、ランダムに電話をかけて知らない人と話せるアプリなんかもあるようですね。


 そういうものへの需要が「大きい」とは、私は思いません。2ちゃんねる的なものも、たまに使う分にはちょっとワクワクして楽しいというぐらいの話で、毎日入り浸っていたら不愉快な経験のほうが目立つようになってきます。そういう空間に閉じこもってしまうのは、トイレから出られなくなるようなもので、本当に孤立している不幸な人だけでしょう。


 しかし、海に投げた手紙が誰かに届くというエピソードと同じで、「便所の落書き」にも独特なロマンがあるのだということは認めるべきです。そこには、「アカウント」を軸に投稿が整理されてしまっている今のSNSにはない面白さがあったのです。私にとっては、インターネットの「2ちゃんねる」より、本当に便所の壁に書いていた「一学2ちゃんねる」のほうがよりロマンがありましたが、本質は似ていると思います。


 私は高校2年ぐらいのときに「あめぞう掲示板」を使いはじめて、その後、違いがよくわからないまま気づいたら「2ちゃんねる」に移動していました。当時のインターネットには、なんというか、少年の「冒険心」をくすぐるところがありました。知らない人と顔も名前も年齢も分からないまま話し合うっていうのが、ちょっと怪しい、ちょっと危うい、ちょっと悪いことをしているような感覚で、刺激的だったんです。たぶん、その前の時代の「パソコン通信」や、アマチュア無線でたまたまつながった人と雑談をするのも似た感じだったんじゃないでしょうか。


 これはたぶん、インターネットが流行り出した頃、周りよりも早めに使いはじめた人にしか分からない感覚だと思います。使う人が多くなるとトラブルも増えるしコミュニケーションの質も下がってしまって、ドキドキ・ワクワクという感じではなくなったし、そもそもインターネットがあるのが当たり前になると、冒険的ではなくなりますからね。


 私も人に自慢できるほど早かったわけではないし、そもそも「アーリーアダプター」であることが格好いいとも思わなくてむしろ古風な生活スタイルを守っている人に憧れますが、たとえば大学に入った時点で下宿先に常時接続の回線があったのは私ぐらいで、インターネットといえば大学のメディアセンターで使っている人がほとんどだったので(携帯でも接続はできましたが当時は見れるサイトが限られてました)、比較的早いほうだったとは思います。


 で、わずか数年差ぐらいの話ではあるのですが、アーリーアダプター層だけが集まっていた頃の掲示板やチャットルームは、「匿名で怪しいけどなんか凄そうな奴」がいっぱいいて面白かったんです。たとえば、吉野家コピペの元ネタを作ったのは新爆さんという人ですが、吉野家コピペが有名になるよりも前(だったはず)に、お笑い好きが集まる個人サイトの掲示板で新爆さんの書き込みを見て、腹がちぎれるほど笑ったのを覚えています。ちなみに、吉野家コピペが出回るようになってからも15年ぐらいの間、私は元ネタの作者が新爆さんだとは知らなくて、あのコピペとは無関係に新爆さんというキャラクターを記憶してました。


 SNSが登場して以降のインターネットは、「(凄くて)怪しくない人」と「(怪しくて)凄くない人」ばかりになって、私自身はもちろん後者ですが、とにかく当時のような不思議な味わいが得られる機会は減りました。それは残念な面もあるのですが、避けられない道であったとも思うし、それこそ数年限りの「儚い」体験だったからこそいい思い出になっているのかも知れません。


(参考:このブログのおすすめ記事一覧はコチラ)

天体望遠鏡のトレンドが90年代とはだいぶ変わっていた

 最小二乗法の歴史を調べていたら(先日のエントリ)、かつて統計学を発展させたのは「天体観測」と「測量」だったのだなぁということを改めて実感したのですが、そういえば私は中高生だった1990年代に天体写真を撮っていました。で、「そういえばいまの望遠鏡のトレンドってどうなってるんだろう?」と思ってメーカーのサイトを見てみたら、当時とはかなり考え方が変わっているなと思いました。一言でいえば、「屈折式の地位がめちゃめちゃ上がってる」ということです。


 まず前提として90年代当時の「天体望遠鏡選び」の基本を整理しておくと、

  • 屈折式:対物レンズと接眼レンズから構成されるもので、理科の授業とかで触れるのも、漫画とかで描かれるのもこのタイプが多いが、大口径化することが難しい(レンズは鏡に比べて高価)ので、写真撮影ではあまり使っている人がいなかった。
  • 反射式(ニュートン式):対物レンズのかわりに主鏡で光を集めて鏡筒の横から覗くやつ。大口径のものでも比較的安価なので、太陽観測などを除けばどのジャンルでもこれが最もポピュラー。密閉されてないので、主鏡にホコリがついたり結露したりするのを気にする必要があり、光軸調整も必要なので、扱いはけっこう面倒。
  • シュミットカセグレン式:屈折と反射のいいとこ取りで、鏡で光を集めるので屈折式よりは大口径化しやすく、鏡筒が密閉されているので扱いがちょっと楽。ただし反射式より高価なので、金持ちの(大人の)贅沢品というイメージなのと、焦点距離が長めでちょっと暗い。
  • ドブソニアン式:大口径化に振り切ったやつで、雑誌などで見かけることはあるし面白いが、マニアックすぎてふつうは選択肢にならない。


という感じでした。中高生だった頃(高校時代は競馬のほうが頑張っていたのでほぼ中学時代)の知識なので不十分とは思いますが、天文ガイドのような雑誌は隅々まで読んでいたのと、専門書もけっこう買い揃えていたので(光学などの細かい理論は理解できませんでしたが)、大きく外れてはないと思います。


 この当時の一番のポイントは、とにかく撮影時に長時間露光をする必要があるので、光量をかせぐために「大口径が正義」だったことです。
 当時は、デジタルの冷却CCDカメラというものが少し出始めてはいましたが、フィルム撮影が主流でした。また、パソコンでの画像処理(当時は「電子暗室」とか呼ばれてましたw)環境も持っていない人が多かったと思います。色調の調整をするなら、自宅に暗室をつくって現像とプリントで頑張るという感じでした。
 フィルムは、現代のデジカメのセンサーに比べると感度が弱いので、暗い天体を撮る場合は長時間の露光が必須でした。私は月面のクレーターの拡大写真と、木星・土星ばかり撮っていたのですが(スペック的に土星はかなり厳しかったですが)、月のような明るい天体でも強く拡大すると暗くなるので、1/2秒から2秒ぐらいは開けてたと思います。惑星になると、うろ覚えですが、10秒ぐらい露光することもあったような。


 経験がない人にはなかなかイメージできないと思いますが、長時間露光するときは、カメラ本体のシャッターを使わず、文字通り「手動」で露出時間を調整します。どういうことかというと、まず黒く塗った板を手で持って、それを望遠鏡の先っぽにかざして光が入らないように塞ぎます(鏡筒に接触はしないように)。次に、接眼レンズにマウントしたカメラのシャッターを解放します。この時、望遠鏡が微細に振動するので、それが収まるまでしばらく待ちます。そして、もういいかなと思った頃に、かざしている黒い板をどけて露光を開始し、1/2秒とか1秒とか数えて塞ぎます。その後に、カメラ自体のシャッターも閉じる。


 光量確保のために長時間の解放が必要で、何百倍という拡大率で撮影していると少しの振動でもボヤけてしまうので、こういう手順で撮るのが一般的だったと思います。で、フィルム撮影だとその場で写真の確認はできませんから、何十回も撮っておいて、後日現像に出して運よく良いものが撮れているか確認するという流れです。露出時間もいろいろなパターンを試して、何枚目が何秒だったかというのをノートに記録しておき、その後の参考にします。
 ちなみに最近は、惑星や月の撮影で長時間露光はしないみたいですね。デジタルで連続撮影してきれいなものを重ね合わせるという手法が強いようです。


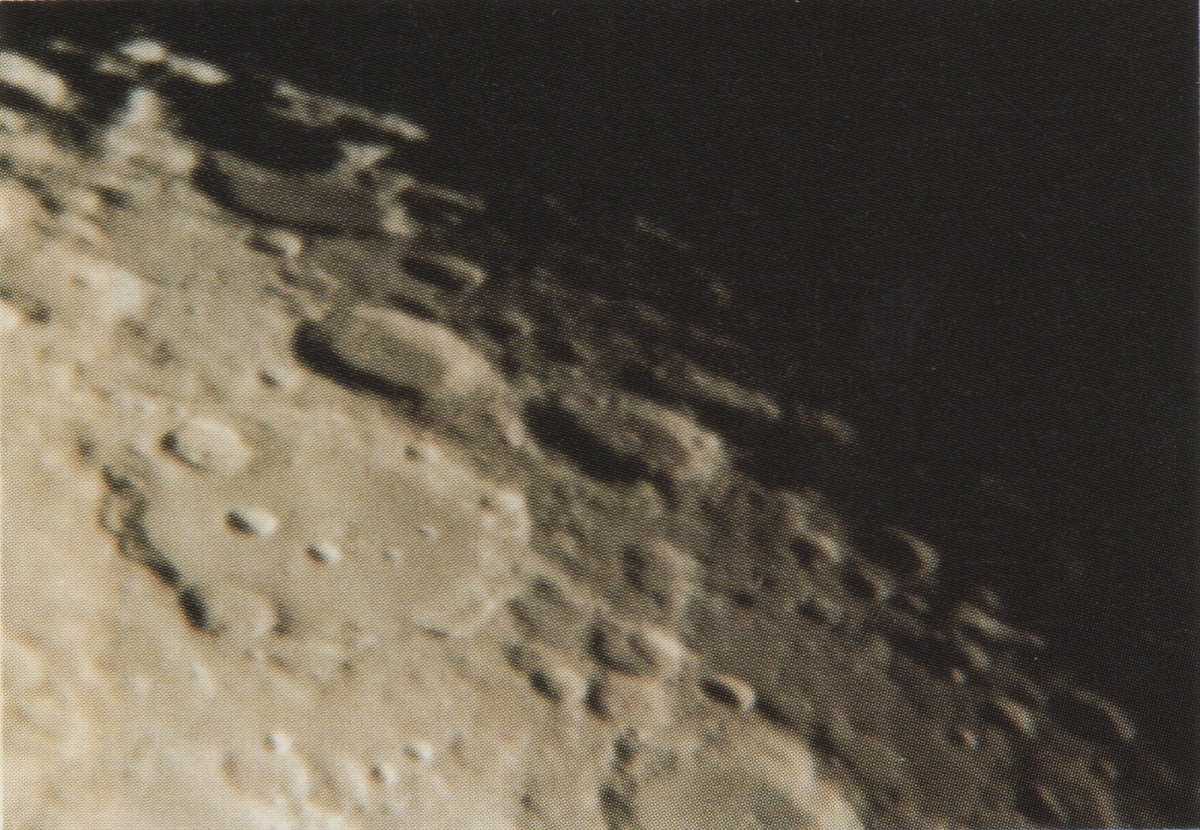
 『天文ガイド』の18歳未満の部に3度掲載してもらいましたが、そのうちの一枚がこれです。少しぼやけていて褒められるようなクオリティではないですが、11.4cmという小口径の望遠鏡で中学生が撮ったものなので、大目に見てください(笑)


 集光力は対物レンズや主鏡の口径の二乗に比例しますので、上述のような環境だと、とにかく「大口径が正義」ということになります。光量があればあるほど、拡大率を引き上げることもできますし、露光時間が短時間で済むので振動(や大気のゆらぎ)の影響を受けにくくなって、綺麗な写真が撮れます。惑星とかを狙うのであれば、だいたい20cmクラスぐらいの望遠鏡を持っていないと雑誌の投稿欄で掲載を争えるような写真は撮れない感じでしたが、私とおなじ機種で、ガイドスコープによる補正などを駆使して木星か何かのきれいな写真を撮っている人もいたので、気合で乗り切れる面もあるのだなと感心したりしていました。


 まぁいずれにしても、大口径原理主義になりがちなので、口径あたりのコストが安いニュートン反射式が圧倒的に主流でした。色収差がないというメリットもあるらしいですが、そんなことよりまずはとにかくコスパでしょう(笑)。屈折式は眼視がしやすいので、写真以外の用途ではよく使われていたと思います。眼視のほうが明るく見えやすいんで。


 今でも、コスパの良さから、大口径の反射式を買ってより本格的な(というか暗くて撮りにくい)天体を……というムーブは当然あると思いますが、デジカメのセンサーがかなり優秀で、かつてのフィルムより感度がいいようです。そうなると、昔ほど大口径にこだわらなくてもよく、扱いが楽な屈折式が写真撮影用途で現実的な選択肢になってくるんでしょうね。
 もともと屈折のほうが、筒内気流や反射時の散乱がなく、コマ収差と言われる滲みもないので、原理的に反射式よりシャープに撮れるという強みがあって、それが活かせるようになったのだと思います。しかも、アポクロマートという技術で色収差の問題がほぼなくなったみたいですし。
 星雲などで長時間露光するにしても、ガイドスコープを使ったオートガイドの精度が上がっているようで、そのことも「小口径でも撮れる」を後押ししてるのかも知れません。色収差の補正技術が向上した結果、短焦点化が可能になり、明るく撮れる屈折式が増えたってのもありそうです。


 いずれにしても、私は天体写真撮影用の望遠鏡としては、「ニュートン反射一強」という認識だったので、屈折式の地位が上がっていることを知って驚きました。市場シェアとしても、屈折式のほうが売れているそうです(参考リンク)。昔は、月でも惑星でも星雲星団でもニュートン反射がバンバン使われてましたが、今は月・惑星では屈折式かシュミットカセグレン式が使われていて、反射式はどちらかというと星雲星団(いわゆる「深宇宙」)撮影用という雰囲気にシフトしてきているようです。時代は変わるものですね〜。


(参考:このブログのおすすめ記事一覧はコチラ)

統計的因果推論の手法を選ぶためのチートシート

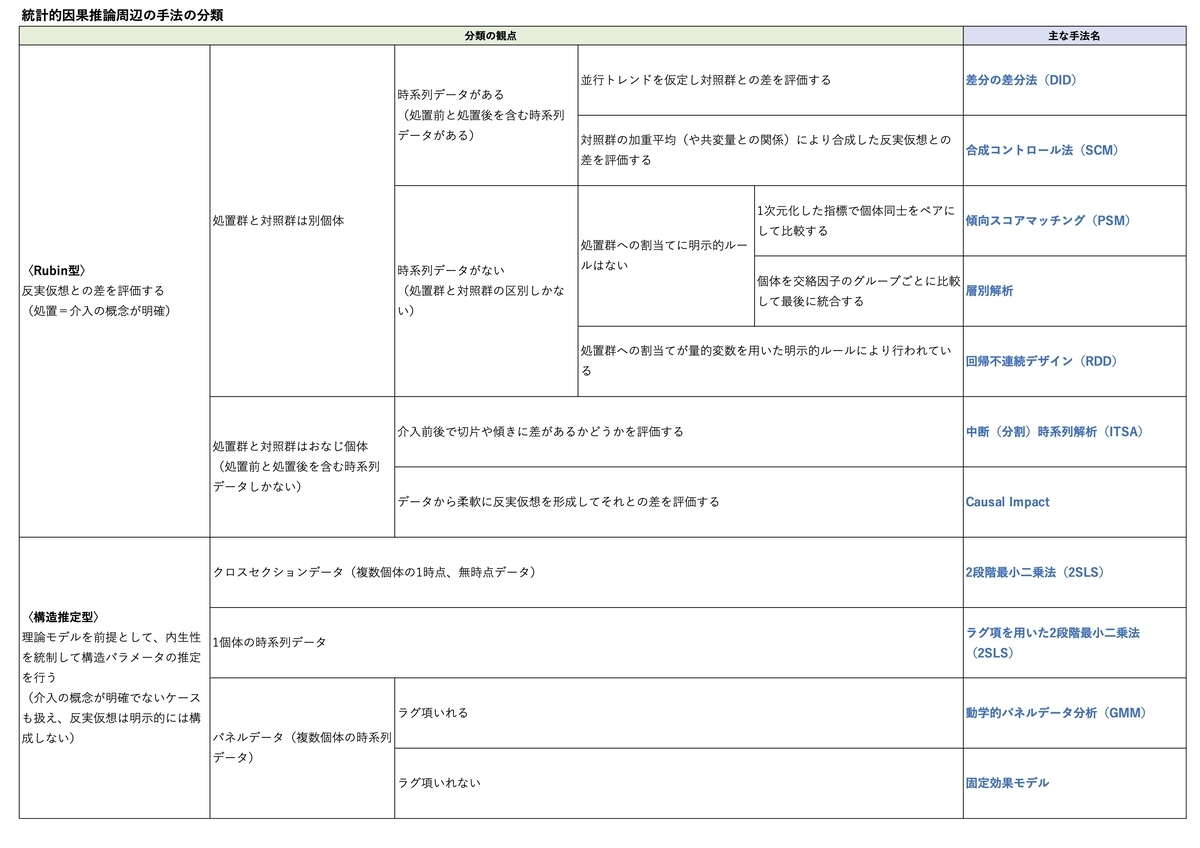
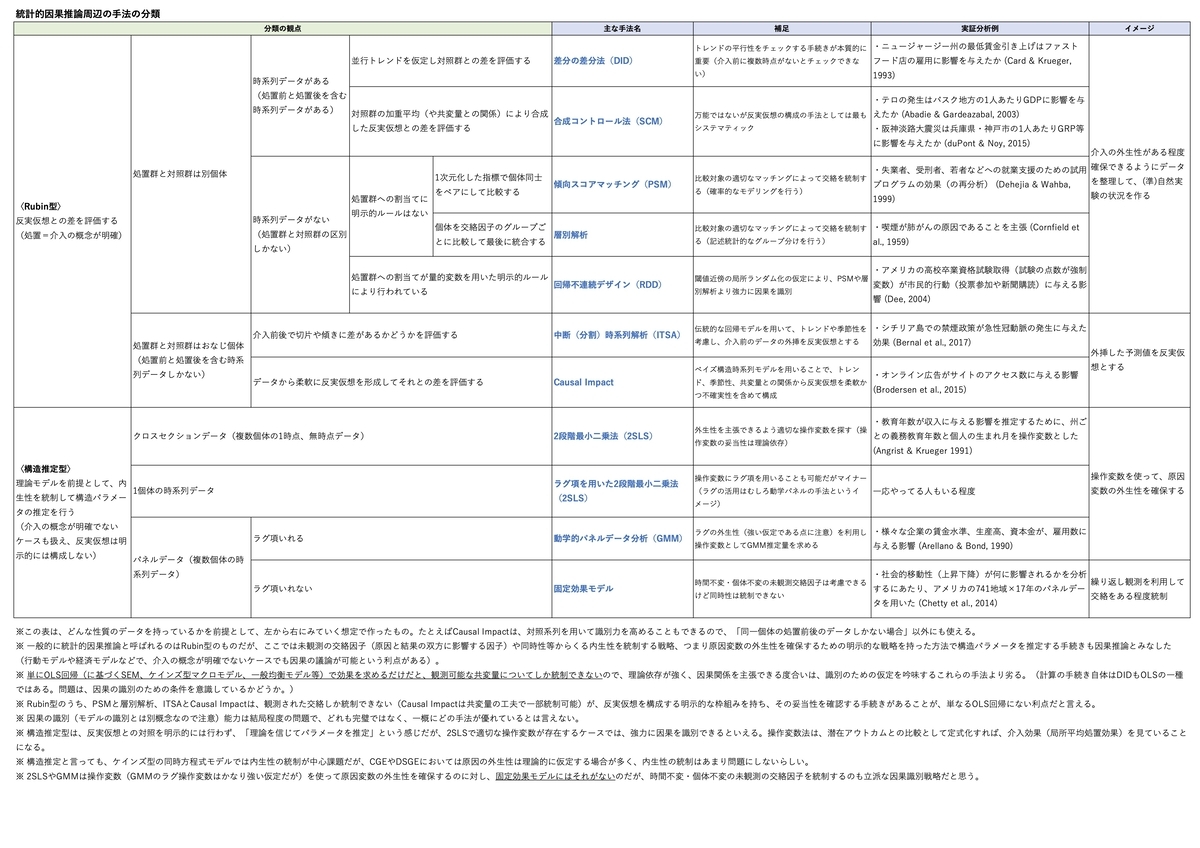
 統計的因果推論について、学生とかが「手元にどんなデータがあるか」に応じて使える手法を大雑把に判断するためのチートシートのようなものを作っているのですが、正直私自身もあまり理解してなくて、正確性を気にしていたらキリがないと思い、いったん現行版を掲載しておきます。
 間違いに気づいたら随時修正します。無理やり一枚にまとめようとした感じなので、分類の切り口を含めて、もっといい整理法がありましたら教えてください。


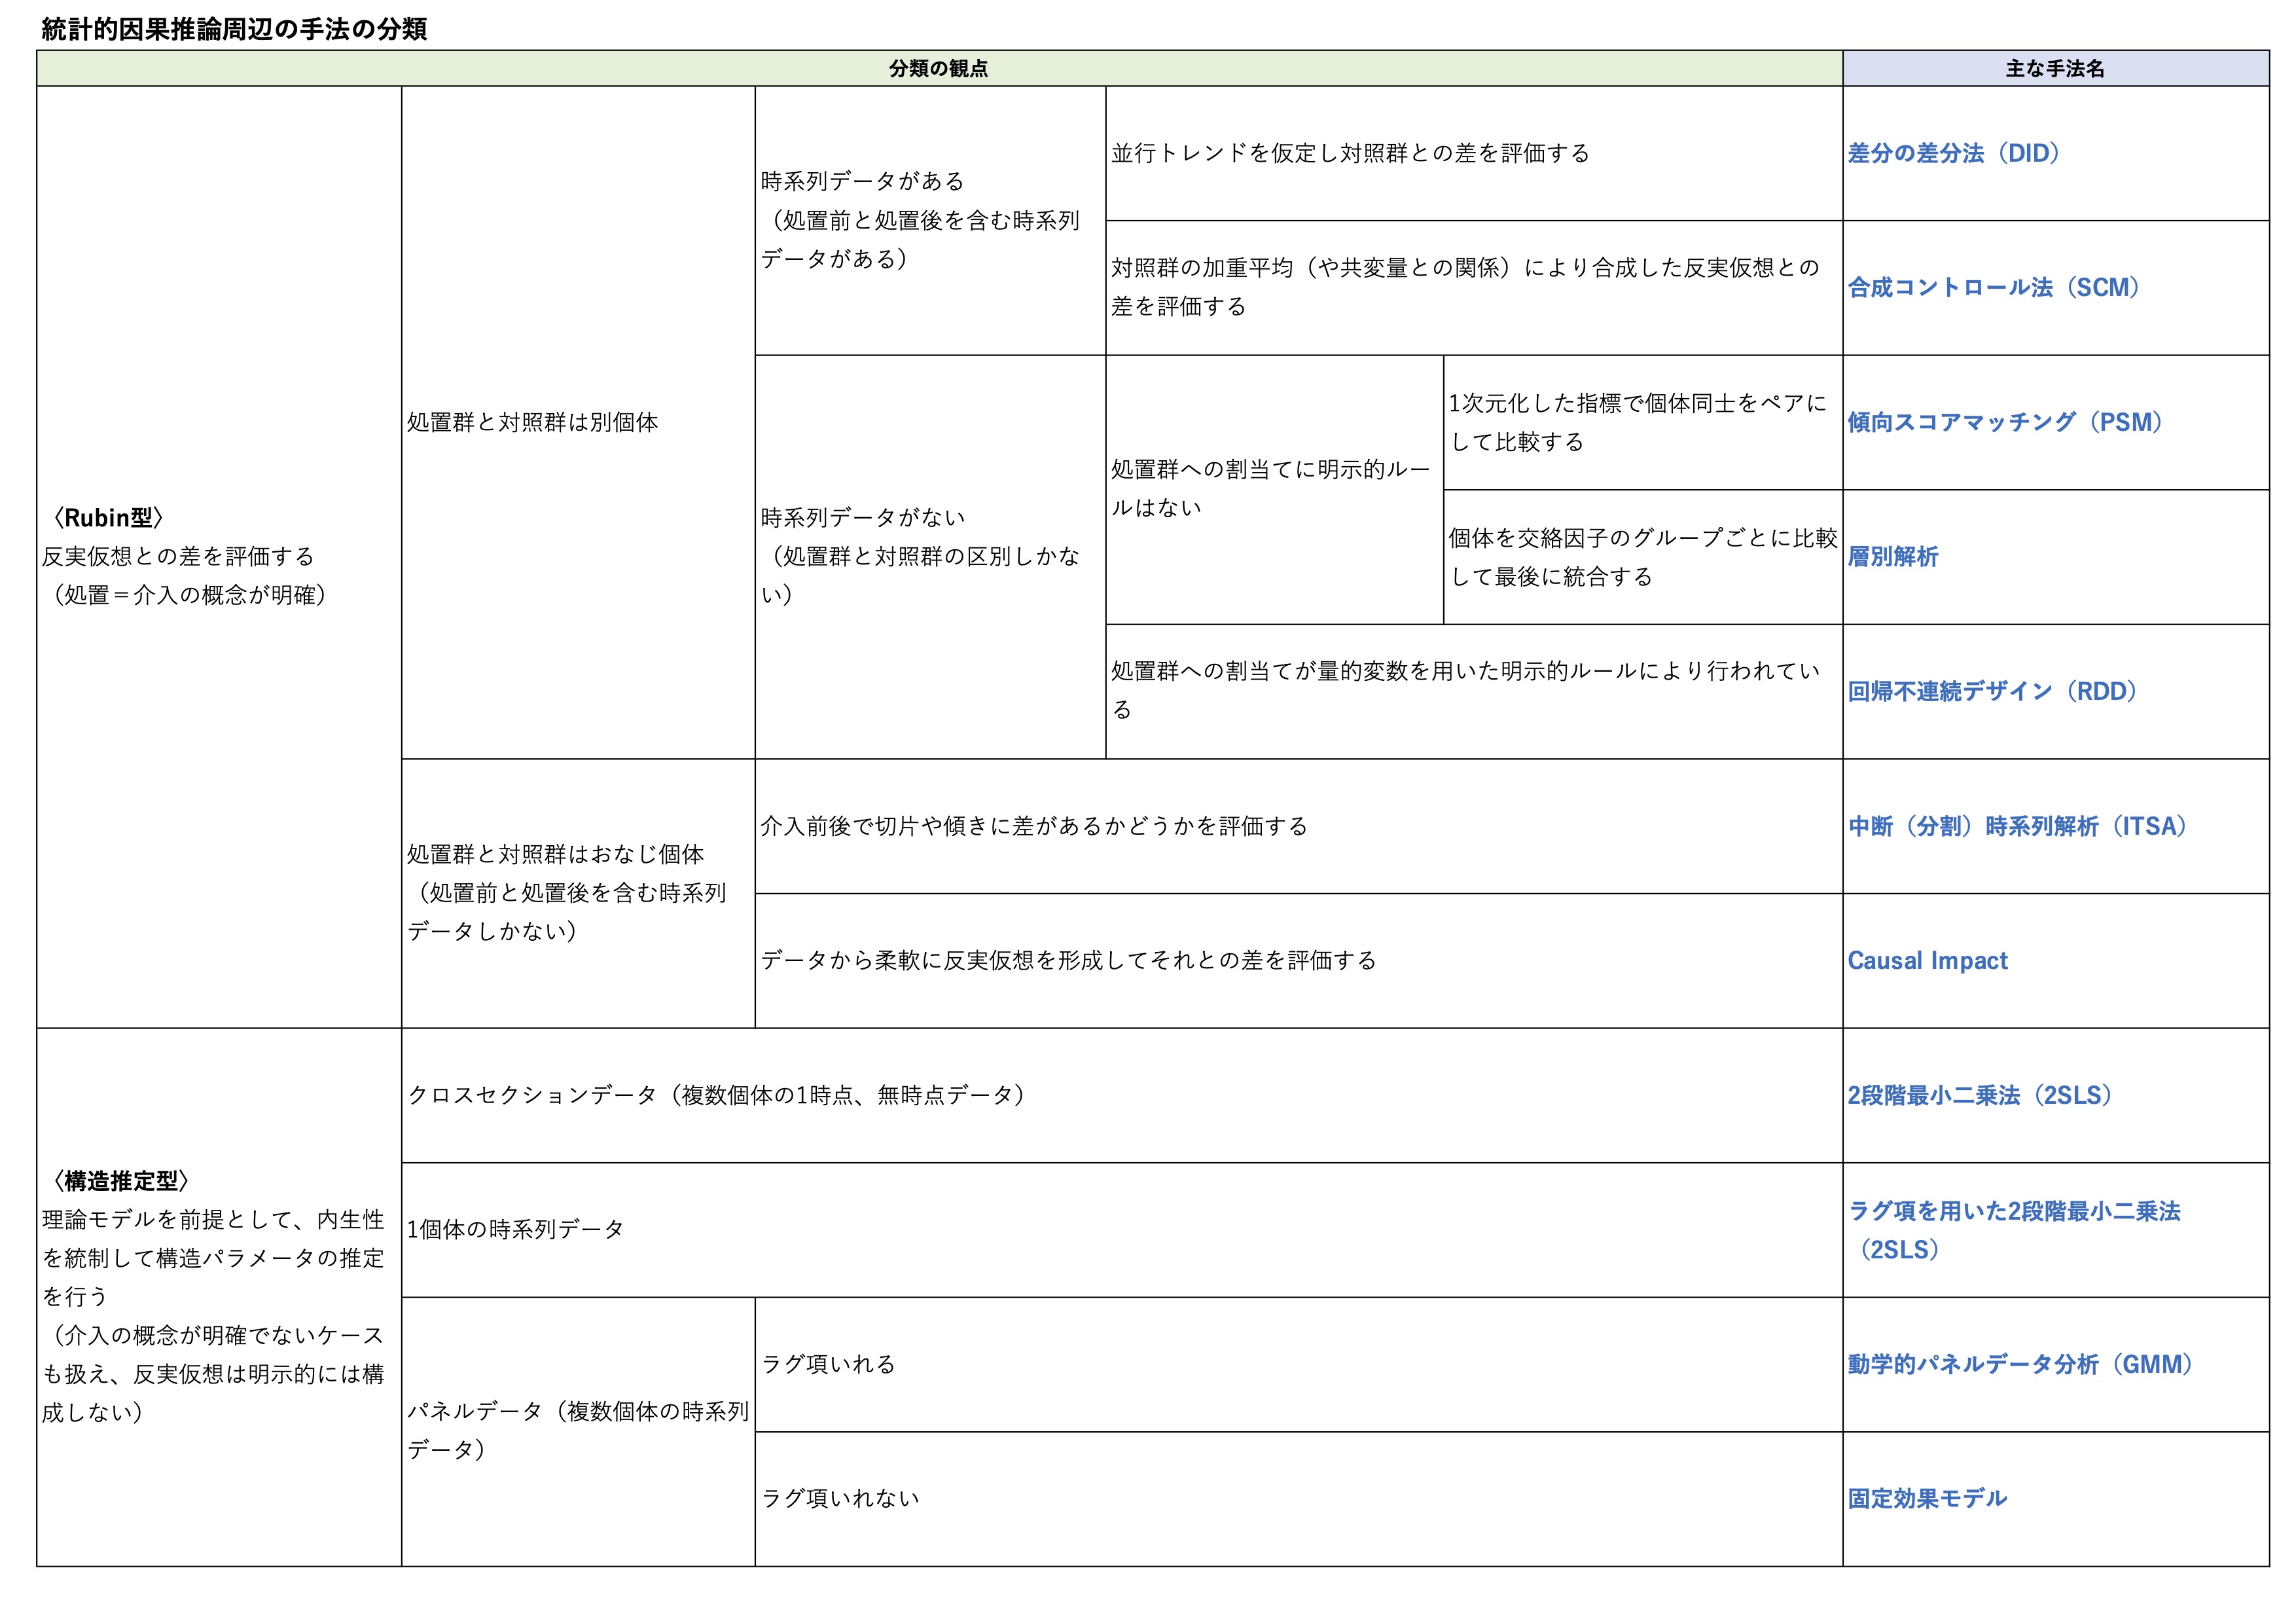
 まず、一番大雑把な表がこちらです。【オリジナル画質で見る場合はコチラ】


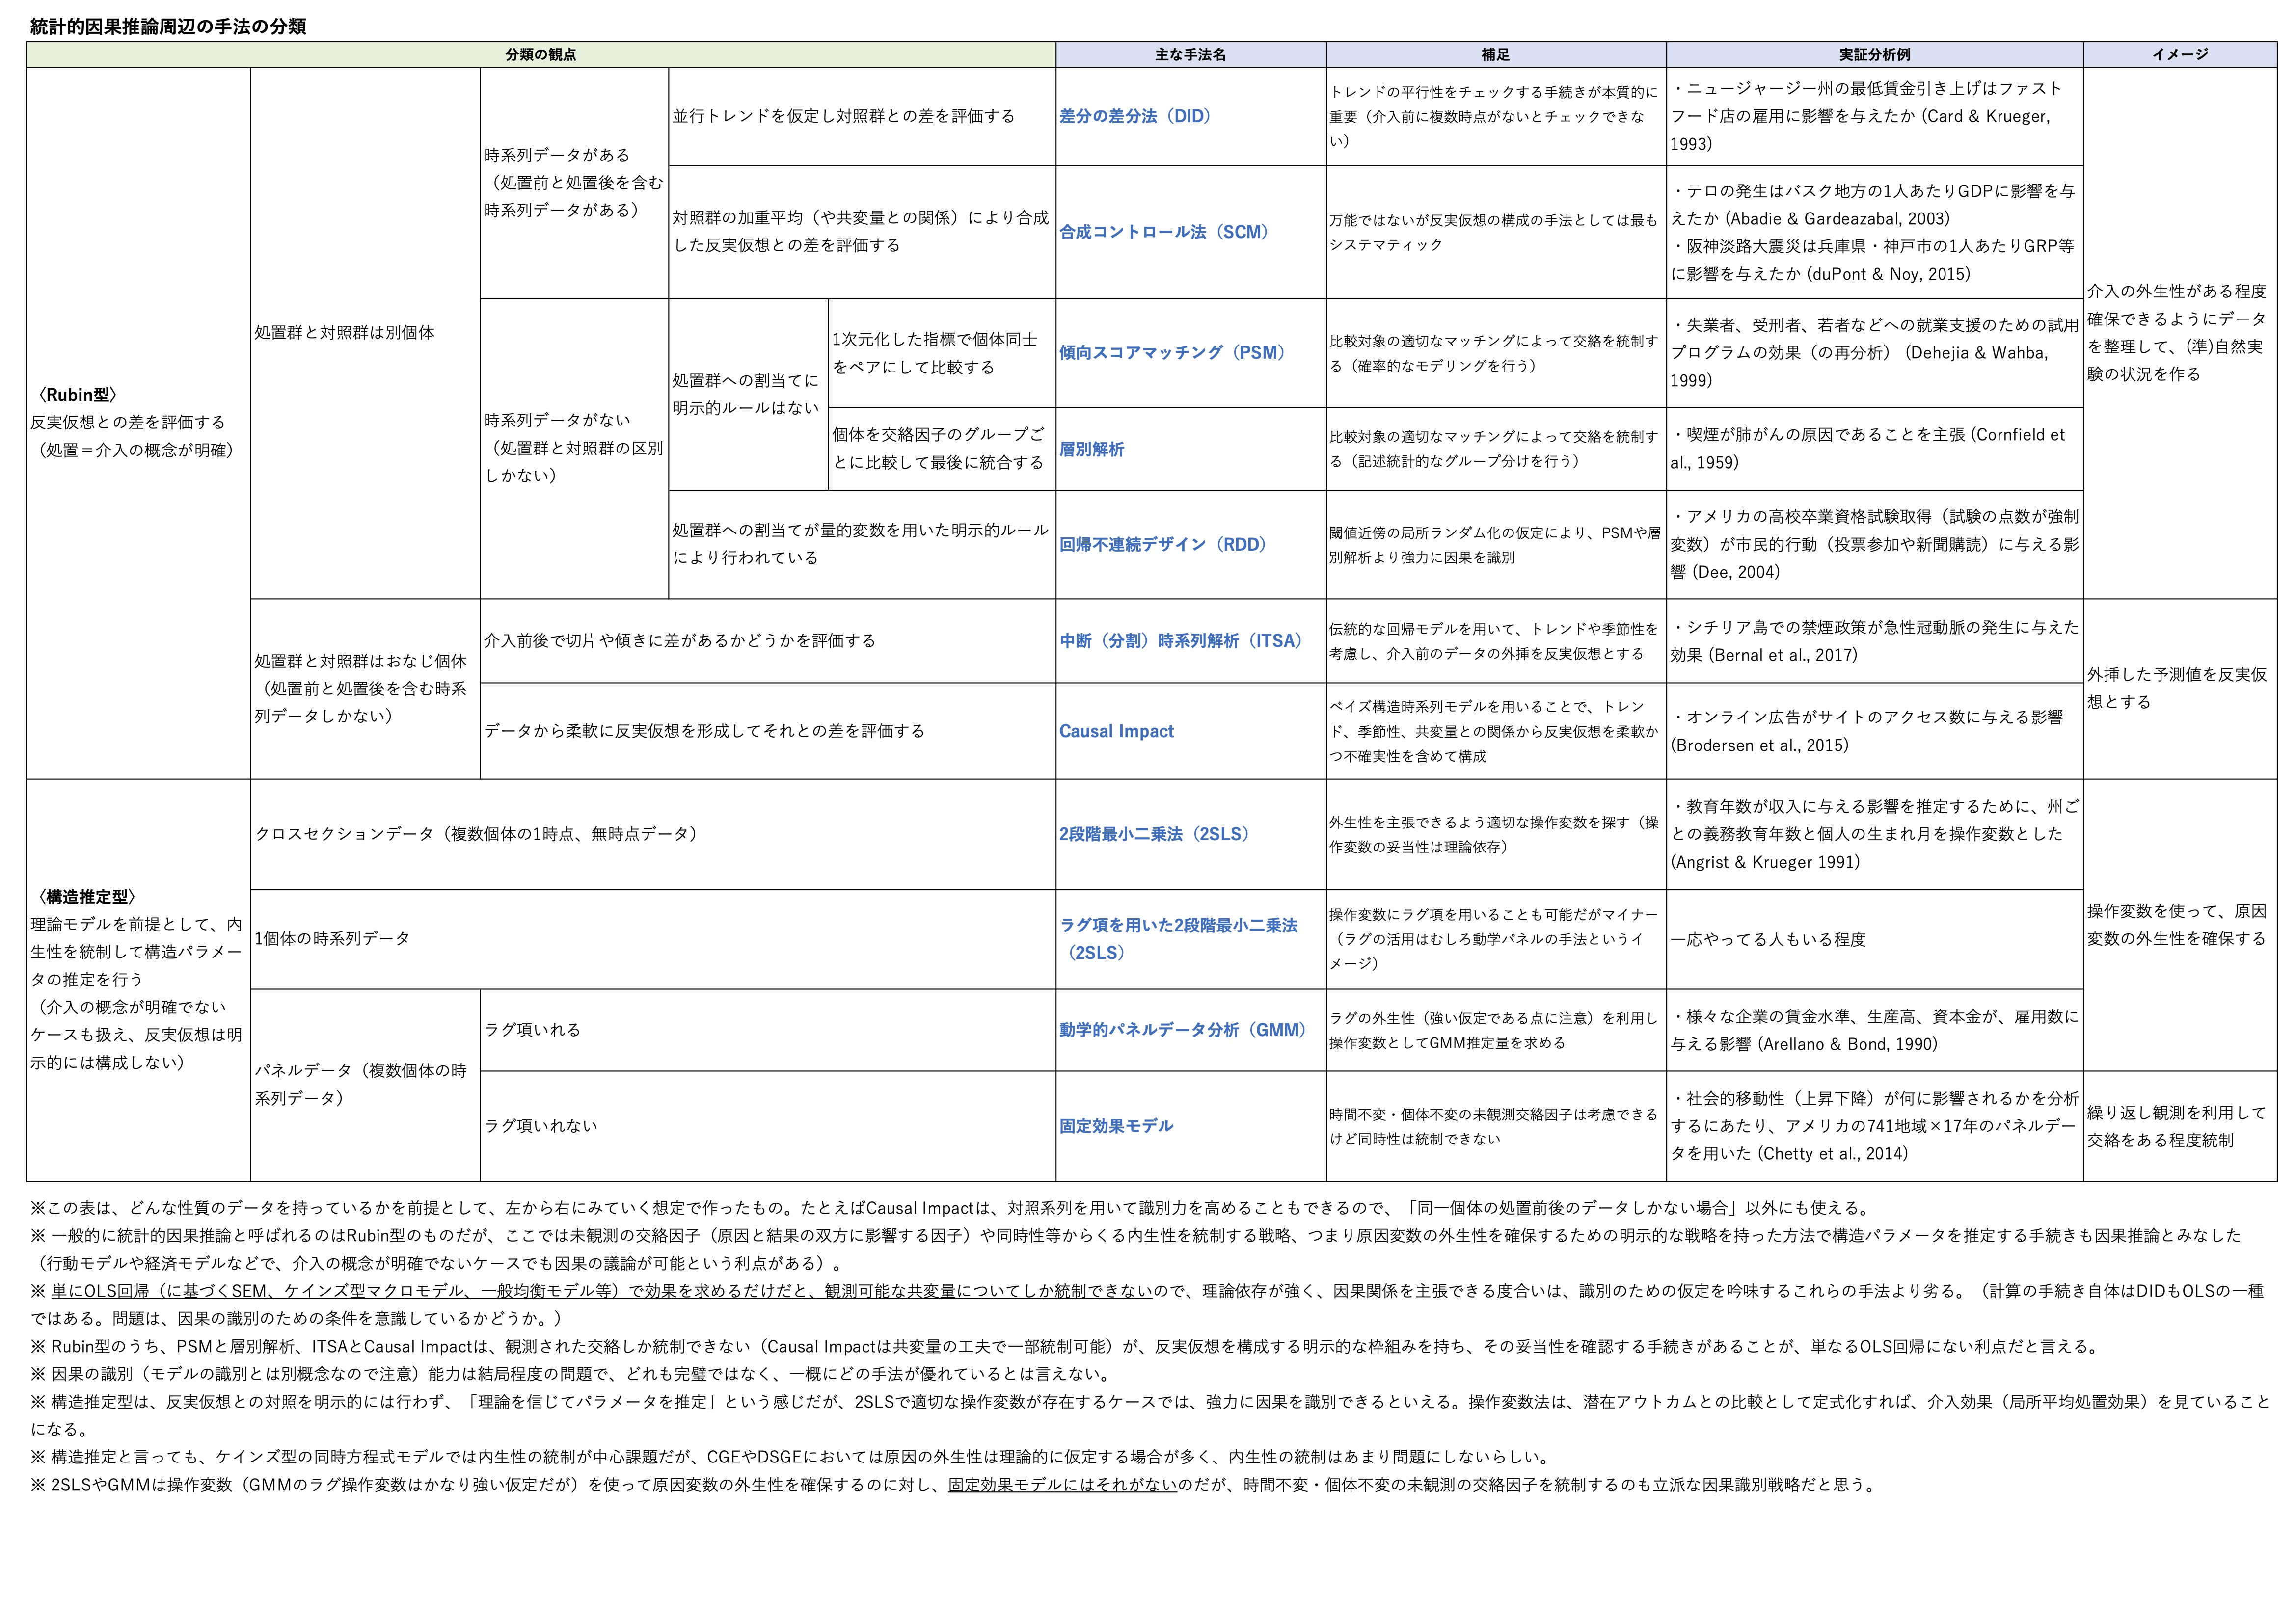
 情報をいろいろ補ったものがこちらです。【オリジナル画質で見る場合はコチラ】


 「こういうデータにはこの手法しか使えない」という意味ではないです。工夫すればいろいろなタイプのデータに適用可能な手法も多いので、あくまで「こういうデータを持っているときに、とりあえず検討してみるのはこの手法かな」と見当をつけるための早見表です。


 上の段と下の段の分け方は、理論的にはあまりスッキリしてないとは思います。2SLSや固定効果モデルを、Rubin的な介入効果の分析にも使えるわけなので。
 何というか、ぶっちゃけて言うと私が属している分野(都市計画周辺の工学)の空気感としては、

  • 上の段は「最近耳にするようになった統計的因果推論の話題に、意識的についていこうとしないと、よく分からないままになる手法」
  • 下の段は「伝統的な統計分析の教育を受けてふつうに生きていれば、どこかで触れることがありそうな手法」

という感じになりまして(笑)、理論的な正確さや明快さより、そういう日常的感覚みたいなもので分けておきたかったというのが大きいです。あまり統計分析の手法について突き詰めて考える人は多くない分野なので、私を含めて認識は雑だと思います。
 ちなみに私自身、実際に回したことがあるのはSCM・DID・PSM・2SLS・GMMぐらいで、論文で使ったことあるのはたぶんSCM・GMMだけだなので、とても正確に理解してるとは言えません。自分が今後勉強するための、頭の整理という感じでもあります。


 画像だけというのもイマイチなので、以下にテキストでも書いておきます。

Rubin型

 処置=介入の概念が明確で、「反実仮想との差」を評価することを強く意識した手法です。最近流行りの「統計的因果推論」というと、これらをイメージすることが多いと思います。

処置群と対照群 時系列データ 割当ルール 反実仮想の構成方法 手法
別個体 あり ― 並行トレンドを仮定し対照群との差を評価 差分の差分法(DID)
別個体 あり ― 対照群の加重平均や共変量との関係から合成反実仮想を構成 合成コントロール法(SCM)
別個体 なし 明示的ルールなし 1次元化した指標で個体同士をペア比較 傾向スコアマッチング(PSM)
別個体 なし 明示的ルールなし 交絡因子ごとに層別し比較後に統合 層別解析
別個体 なし 量的変数による閾値ルール 閾値近傍の局所比較 回帰不連続デザイン(RDD)
同一個体 あり(前後のみ) ― 切片や傾きの変化を評価 中断(分割)時系列解析(ITSA)
同一個体 あり(前後のみ) ― ベイズ構造時系列で柔軟に反実仮想を構成 Causal Impact

構造推定型

 伝統的な経済モデルとかで使われているもので、理論モデルを前提として、内生性を統制して構造パラメータの推定を行うものです。反実仮想を明示的には構成せず、介入の概念が明確でないケースも扱いますが、反実仮想との差を評価していると解釈することができるケースもあると思います。

データ構造 ラグ項の利用 推定アプローチ 手法
クロスセクションデータ(複数個体・1時点) なし 外生的な操作変数を用いる 2段階最小二乗法(2SLS)
1個体の時系列データ あり ラグ項を操作変数として利用 ラグ項を用いた2段階最小二乗法
パネルデータ(複数個体の時系列) あり ラグの外生性を仮定しGMM推定 動学的パネルデータ分析(GMM)
パネルデータ(複数個体の時系列) なし 個体固定効果により時間不変の未観測要因を除去 固定効果モデル

各手法のイメージ

表に載せている各手法のイメージに関するメモも、テキストで書いておきます。
代表的な文献の引用は、AIにチェックさせたら「それはワーキングペーパー版であって、査読論文は年号がXXXXになる」という指摘が3つぐらいありましたが、面倒なのでそのままにしています。

手法 特徴・本質的ポイント 代表例
差分の差分法(DID) トレンドの平行性をチェックする手続きが本質的に重要(介入前に複数時点がないとチェックできない) ニュージャージー州の最低賃金引き上げはファストフード店の雇用に影響を与えたか(Card & Krueger, 1993)
合成コントロール法(SCM) 万能ではないが反実仮想の構成の手法としては最もシステマティック テロの発生はバスク地方の1人あたりGDPに影響を与えたか(Abadie & Gardeazabal, 2003)
阪神淡路大震災は兵庫県・神戸市の1人あたりGRP等に影響を与えたか(duPont & Noy, 2015)
傾向スコアマッチング(PSM) 比較対象の適切なマッチングによって交絡を統制する(確率的なモデリングを行う) 失業者、受刑者、若者などへの就業支援のための試用プログラムの効果の再分析(Dehejia & Wahba, 1999)
層別解析 比較対象の適切なマッチングによって交絡を統制する(記述統計的なグループ分けを行う) 喫煙が肺がんの原因であることを主張(Cornfield et al., 1959)
回帰不連続デザイン(RDD) 閾値近傍の局所ランダム化の仮定により、PSMや層別解析より強力に因果を識別 アメリカの高校卒業資格試験取得(試験の点数が強制変数)が市民的行動(投票参加や新聞購読)に与える影響(Dee, 2004)
中断(分割)時系列解析(ITSA) 伝統的な回帰モデルを用いて、トレンドや季節性を考慮し、介入前のデータの外挿を反実仮想とする シチリア島での禁煙政策が急性冠動脈の発生に与えた効果(Bernal et al., 2017)
Causal Impact ベイズ構造時系列モデルを用いることで、トレンド、季節性、共変量との関係から反実仮想を柔軟かつ不確実性を含めて構成 オンライン広告がサイトのアクセス数に与える影響(Brodersen et al., 2015)
2段階最小二乗法(2SLS) 外生性を主張できるよう適切な操作変数を探す(操作変数の妥当性は理論依存) 教育年数が収入に与える影響を推定するために、州ごとの義務教育年数と個人の生まれ月を操作変数とした(Angrist & Krueger, 1991)
ラグ項を用いた2段階最小二乗法 操作変数にラグ項を用いることも可能だがマイナー(ラグの活用はむしろ動学パネルの手法というイメージ) 一応やっている研究者もいる程度
動学的パネルデータ分析(GMM) ラグの外生性(強い仮定である点に注意)を利用し操作変数としてGMM推定量を求める 企業の賃金水準、生産高、資本金が雇用数に与える影響(Arellano & Bond, 1990)
固定効果モデル 時間不変・個体不変の未観測交絡因子は考慮できるが同時性は統制できない 社会的移動性が何に影響されるかを分析(アメリカの741地域×17年のパネルデータ)(Chetty et al., 2014)

注記

 表の下に言い訳のようにダラダラ書いてるメモもコピペしておきます。

  • この表は、どんな性質のデータを持っているかを前提として、左から右にみていく想定で作ったもの。たとえばCausal Impactは、対照系列を用いて識別力を高めることもできるので、「同一個体の処置前後のデータしかない場合」以外にも使える。
  • 一般的に統計的因果推論と呼ばれるのはRubin型のものだが、ここでは未観測の交絡因子(原因と結果の双方に影響する因子)や同時性等からくる内生性を統制する戦略、つまり原因変数の外生性を確保するための明示的な戦略を持った方法で構造パラメータを推定する手続きも因果推論とみなした(行動モデルや経済モデルなどで、介入の概念が明確でないケースでも因果の議論が可能という利点がある)。
  • 単にOLS回帰(に基づくSEM、ケインズ型マクロモデル、一般均衡モデル等)で効果を求めるだけだと、観測可能な共変量についてしか統制できないので、理論依存が強く、因果関係を主張できる度合いは、識別のための仮定を吟味するこれらの手法より劣る。(計算の手続き自体はDIDもOLSの一種ではある。問題は、因果の識別のための条件を意識しているかどうか。)
  • Rubin型のうち、PSMと層別解析、ITSAとCausal Impactは、観測された交絡しか統制できない(Causal Impactは共変量の工夫で一部統制可能)が、反実仮想を構成する明示的な枠組みを持ち、その妥当性を確認する手続きがあることが、単なるOLS回帰にない利点だと言える。
  • 因果の識別(モデルの識別とは別概念なので注意)能力は結局程度の問題で、どれも完璧ではなく、一概にどの手法が優れているとは言えない。
  • 構造推定型は、反実仮想との対照を明示的には行わず、「理論を信じてパラメータを推定」という感じだが、2SLSで適切な操作変数が存在するケースでは、強力に因果を識別できるといえる。操作変数法は、潜在アウトカムとの比較として定式化すれば、介入効果(局所平均処置効果)を見ていることになる。
  • 構造推定と言っても、ケインズ型の同時方程式モデルでは内生性の統制が中心課題だが、CGEやDSGEにおいては原因の外生性は理論的に仮定する場合が多く、内生性の統制はあまり問題にしないらしい。
  • 2SLSやGMMは操作変数(GMMのラグ操作変数はかなり強い仮定だが)を使って原因変数の外生性を確保するのに対し、固定効果モデルにはそれがないのだが、時間不変・個体不変の未観測の交絡因子を統制するのも立派な因果識別戦略だと思う。


(参考:このブログのおすすめ記事一覧はコチラ)